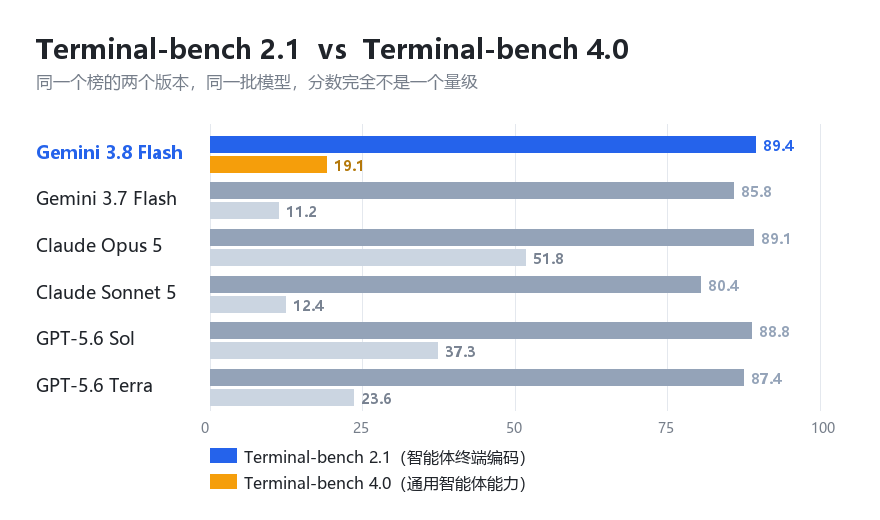
翻新 Flash 的评测表,有一处特别扎眼。Terminal-bench 2.1 上它 89.4,是这一栏里最高的;换到 Terminal-bench 4.0,19.1,Opus 5 在同一栏是 51.8,差了三十多个点。同一批模型同一个榜,两个版本给出的结论几乎是反的。
我知道 2.1 偏终端里的编码任务,4.0 更靠近通用智能体能力,可差到这个程度还是说明一件事:拿单张跑分表下结论基本没意义,你只要挑对版本号,谁都能当第一。看图的时候先看小字写的是哪一版,比看柱子长短重要。
刚上手试了几轮,我的体感反而更接近 4.0 那一栏——接命令行写代码是真利索,但一让它自己规划多步、中途还得处理点意外,就开始飘。你们是按哪张表选模型的,还是干脆不看了。